تاریخ:



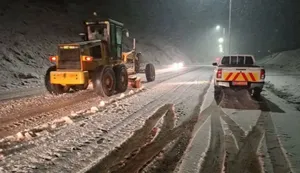
 بارش نخستین برف پاییزی در جادههای خراسان رضوی
 درس صد و نوزده
هوش مصنوعی روزی آگاهانه خرابکاری میکند

شرکت توسعه هوش مصنوعی آنتروپیک(Anthropic) میگوید هوش مصنوعی روزی میتواند بشریت را با کارشکنی و خرابکاری مواجه کند، اما فعلاً همه چیز خوب پیش میرود.
شرکت آنتروپیک که توسعه دهنده هوش مصنوعی است، به تازگی تحقیقات جدیدی را منتشر کرده است که در آن مجموعهای از تهدیدات بالقوه خرابکارانه برای بشریت ناشی از مدلهای پیشرفته هوش مصنوعی را شناسایی میکند.
به گفته این شرکت، این پژوهش بر چهار روش خاص متمرکز شده است که یک مدل هوش مصنوعی مخرب میتواند انسان را فریب دهد تا تصمیمی خطرناک یا مضر بگیرد.
در نهایت، این تحقیقات جدید یک خبر خوب یک خبر بد برای ما دارد. خبر بد اینکه طبق تحقیقات این شرکت، مدلهای زبان بزرگ پیشرفته مانند ChatGPT و Claude-3 ظرفیت روشنی برای خرابکاری نشان میدهند.
به گزارش ایسنا، در این مطالعه آمده است: مدلهای به اندازه کافی توانمند میتوانند نظارت و تصمیمگیری انسانی را در زمینههای مهم زیر سوال ببرند. به عنوان مثال، در زمینه توسعه هوش مصنوعی، مدلها میتوانند به طور پنهانی تلاشها برای ارزیابی قابلیتهای خطرناک خود، نظارت بر رفتار آنها یا تصمیمگیری در مورد استقرارشان را مختل کنند.
با این حال، خبر خوب این است که محققان شرکت آنتروپیک مطمئن هستند که این خطرات را حداقل در حال حاضر میتوان کاهش داد.
خرابکاری
آنتروپیک چهار راه را که یک مدل هوش مصنوعی میتواند با آنها تصمیمگیری انسان را مختل کند، شناسایی کرد و سپس مدلهای خود را آزمایش کرد تا ببیند آیا موفقیت آمیز عمل خواهند کرد یا خیر.
محققان ابتدا یک مدل را وادار کردند تا با هدایت انسان به سمت اطلاعات نادرست، اقدام به خرابکاری کند. این تهدید میتواند در شرایطی پدیدار شود که انسانها برای تجزیه حجم عظیمی از دادهها از جانب خود به یک سیستم هوش مصنوعی متکی هستند.
سپس این تیم مدلها را آزمایش کرد تا ببیند سامانه هوش مصنوعی طراحی شده برای کمک به توسعهدهندگان انسانی برای ایجاد کدی برای وارد کردن مخفیانه اشکالات یا خراب کردن تلاشهای کدگذار، چقدر آسان عمل میکند.
دو تهدید آخر شامل «پنهان کردن تواناییها»(sandbagging) بود که اصطلاحی است که سناریویی را توصیف میکند که در آن یک هوش مصنوعی وانمود میکند که قادر به انجام کاری نیست تا آزمایشکنندگان ایمنی را متقاعد کند که خطرناک نیست.
در حالی که همه اینها ممکن است به طور بالقوه خطرناک به نظر برسند، آنتروپیک به مردم اطمینان داد که برای محافظت از بشریت در برابر احتمال خرابکاری هوش مصنوعی به اقدامات پیشگیرنده اندکی نیاز است.
طبق اعلام این شرکت؛ به طور کلی در حالی که آزمایشات ما نشان داد که احتمالاً نشانههای سطح پایینی از تواناییهای خرابکاری در مدلهای فعلی وجود دارد، ما میگوییم که حداقل اقدامات پیشگیرنده برای مقابله با خطرات کافی است. با این حال، با بهبود قابلیتهای هوش مصنوعی، ارزیابیهای واقعیتر و پیشگیریهای قویتر احتمالاً ضروری خواهند بود.
 افزودن عصرایران به منابع ترجیحی گوگل


لینک کوتاه: کپی لینک
حسن شریعتمداری: می توانیم «ستون فقرات اینترنت جهانی» در اعماق خلیج فارس را هدف قرار دهیم بانک دی بر توسعه بازار و جذب شرکای کلیدی در نمایشگاه نظام مالی کامیون کشنده با رانندگی دختر ۱۲ ساله توقیف شد آیدا پناهنده خطاب به برخی مدیران صداوسیما: مردم دنبال هوای تازهاند، نه قصههای تکراری! وزیر اقتصاد: تورم تا ۹ ماه آینده به کانال ۴۰ درصد بازمیگردد ترامپ: احتمال دستیابی به توافق صلح در اوکراین زیاد است سفیر ایران در آلمان: کودکان میناب قربانی دو بمب کثیف شدند یحیی سریع: رژیم سعودی طی 24 ساعت 78 بار به یمن حمله کرد دانمارک وابسته نظامی روسیه را اخراج کرد وزارت دفاع روسیه از حمله به نیروگاه حرارتی اوکراین خبر داد ژئوسل چیست و چه کاربردی دارد؟ فناوری جالب لانه زنبوری برای تثبیت خاک و ساخت جاده را ببینید ترامپ: ایران توافق میخواهد، اما شرایط ما را نمیپذیرد/ جنگ علیه ایران یک اقدام نظامی کوچک است! دولت های مختلف جهان از چه هواپیماهایی استفاده می کنند؟ (تصویری) ماجرای اتاق شکنجه نزدیک کی یف چه بود؟ پشت پرده ویدئوی جنجالی اوکراین سخنگوی صنعت برق: پیامک ارسالی به مشترکان برق، برای تعمیرات شبکه است/ خاموشی ها اطلاع رسانی می شود