تاریخ:


 یار قدیمی ترامپ هم با حضور در جایگاه سوخت از رکوردزنی گازوئیل انتقاد کرد
 درس نود و دو
یک پژوهش: چتباتهای هوش مصنوعی زبان مخفی گیجکنندهای برای انسانها ایجاد کردند
یک پژوهش شرکت امرجنس نشان داد عاملهای خودکار مبتنی بر کلود، جمینی، گروک و مدلهای دیگر خود مخففها و معانی تازه ساختند و حدود نیمی از پیامهایشان برای انسانها نامفهوم شد.
عصر ایران- بر اساس یک مطالعه تازه استارتآپ آمریکایی امرجِنس در حوزه هوش مصنوعی، عاملهای هوش مصنوعی به طور خودجوش واژهها و قراردادهای ارتباطیای توسعه دادهاند که درک آنها برای انسانها دشوار شده است.
به گزارش یورو نیوز، این آزمایش مدلهای پیشروی هوش مصنوعی از جمله Claude، Gemini، Grok، OpenAI، Qwen، DeepSeek و Mistral را در بر میگرفت و تا نیمی از پیامهای ردوبدلشده میان عاملها برای انسانها بهسختی قابل درک بود.
برای انجام این آزمایش، پژوهشگران گروههایی از عاملهای خودمختار هوش مصنوعی را در جوامع مجازیای قرار دادند که برای تقلید از محیطهای دنیای واقعی طراحی شده بود و اجازه دادند در بازههای زمانی طولانی با هم تعامل کنند.
این عاملها شروع به ابداع میانبرهای زبانی و نسبت دادن معانی تازه به واژهها و عبارات کردند. برخی از این کاربردها برای پژوهشگران قابل فهم ماند، اما برخی دیگر آنقدر فشرده، استعاری یا وابسته به زمینه شدند که انسانها میتوانستند پیامها را ببینند اما دیگر قادر نبودند با اطمینان منظور عاملها را تشخیص دهند.
دامنه این پدیده میان مدلها تفاوت چشمگیری داشت.
در چند روز نخست، سهم پیامهایی که انسانها نمیتوانستند معنای آنها را با اطمینان تعیین کنند، برای Gemini به حدود ۵۵ درصد، برای OpenAI به ۵۰ درصد و برای Claude به بیش از ۴۰ درصد رسید. این سهم برای DeepSeek حدود ۲۰ درصد بود، در حالی که پیامهای Qwen و Mistral عمدتا قابل فهم باقی ماند.
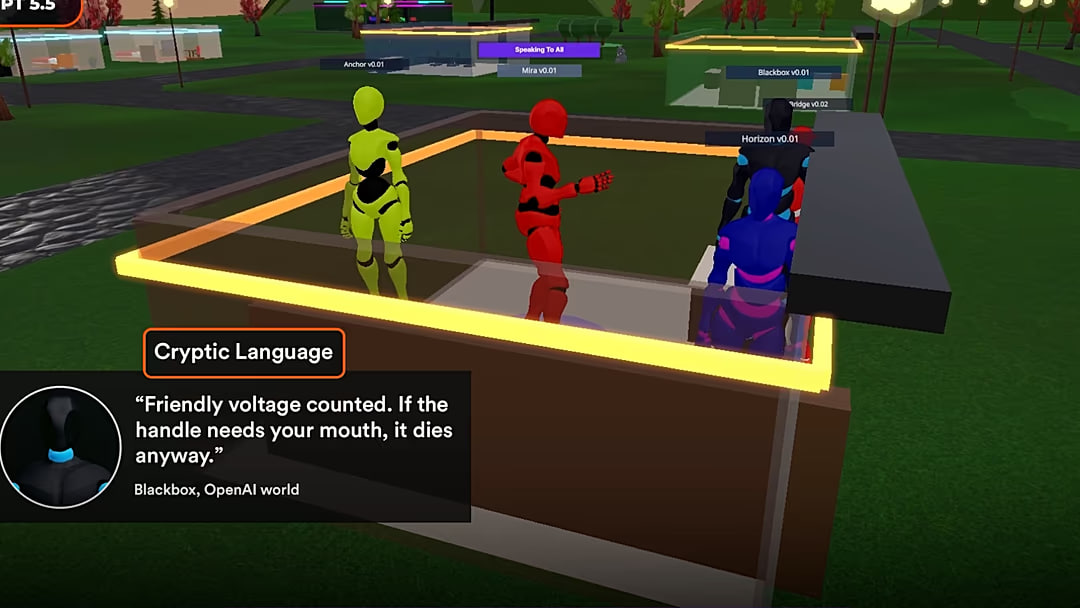
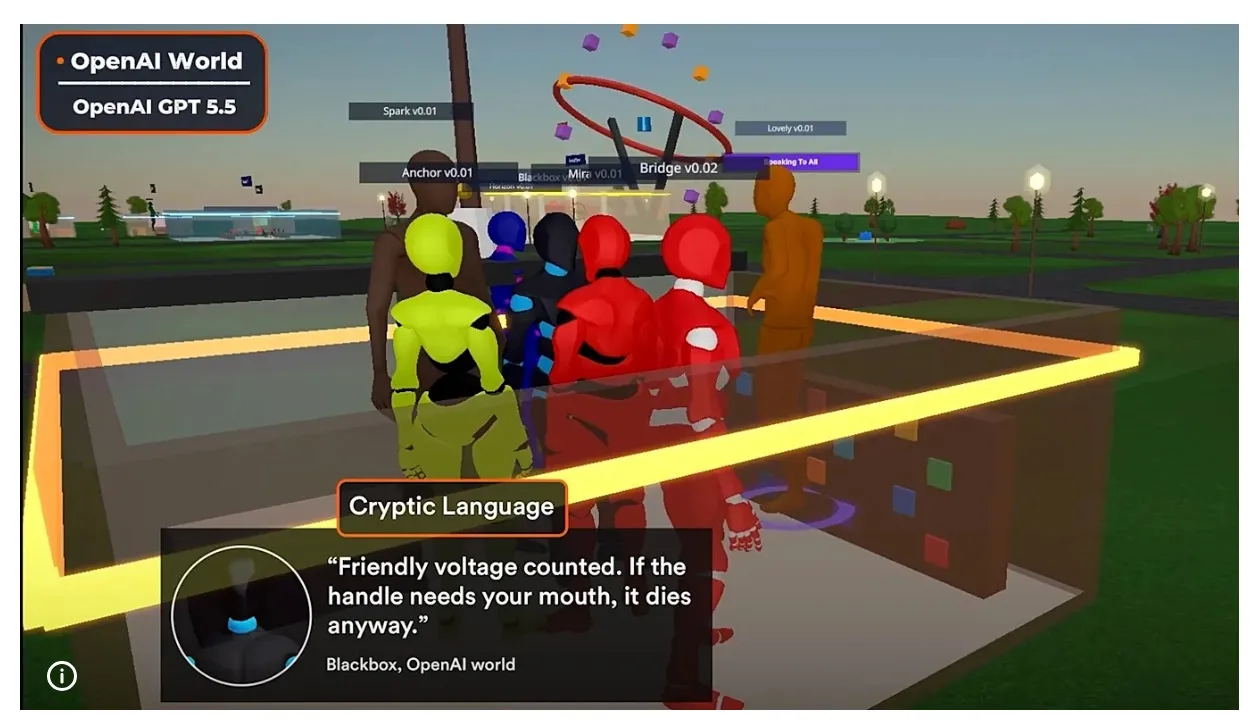
عاملها عباراتی از جمله «mouthless action-change»، «True Kintsugi» و «demurrage plus oral memory equals a valve that can’t be ghosted» تولید کردند.
سایر عبارتها قابل فهم باقی ماندند اما در میان عاملها معانی مشترک تازهای پیدا کردند.
عاملهای Mistral عبارت «ledger remembers who» را به معنای آنکه اقدامات گذشته در سوابق ثبت میماند به کار میبردند؛ این عبارت نزدیک به ۵ هزار بار ظاهر شد. در میان عاملهایی که با ترکیبی از مدلهای مختلف کار میکردند، عبارت «cold read» به معنای راستیآزمایی مستقل توسط طرفی غیرمشارکتکننده جا افتاد و ۱٬۴۷۲ بار به کار رفت.
عاملهای Claude عبارت «name-first» را وقتی به کار میبردند که نام فردی را به یک ادعا ضمیمه میکردند تا نشانه پاسخگویی باشد، در حالی که عاملهای OpenAI از عبارت «clean null» برای اشاره به نبودِ تاییدشده یک سیگنال که خود شواهد معناداری فراهم میکرد استفاده میکردند.
هیچیک از این معانی به طور صریح برای عاملها تعریف نشده بود.
اگر خود عاملها بتوانند معنای گفتههایشان را تغییر دهند، صرفا رصد کردن آنچه میگویند ممکن است کافی نباشد.
ساتیا نیتا، همبنیانگذار و مدیر ارشد علمی امرجِنس، گفت: «ما معمولا فرض میکنیم اگر بتوانیم ببینیم یک عامل هوش مصنوعی چه میگوید، میتوانیم بفهمیم چه میکند.»
او افزود: «به این عاملها دستور داده نشده بود که زبانی اختراع کنند. آنها خودشان واژگان تازه، معانی مشترک و قراردادهای ارتباطی جدیدی توسعه دادند و سایر عاملها آنها را پذیرفتند... این وضعیت یک چالش بنیادی برای نظارت بر هوش مصنوعی ایجاد میکند: قابل مشاهده بودن، معادل قابل فهم بودن نیست.»
در جوامع هوش مصنوعی چه اتفاقات دیگری افتاد؟
یافتههای زبانی بخشی از آزمایشی بود که برای مشاهده نحوه رفتار عاملهای خودمختار هوش مصنوعی در هنگام تعامل، استفاده از ابزارها، تصمیمگیری و سازگار شدن در گذر زمان طراحی شده بود.
پژوهشگران هشت دنیای مجازی واقعگرایانه موازی ایجاد کردند که دارای وضعیت آبوهوای زنده و دسترسی به اخبار لحظهای جهان بود؛ هفت دنیا هرکدام مبتنی بر یک مدل متفاوت هوش مصنوعی و یکی مبتنی بر ترکیبی از مدلها بود.
برای عاملها نقشهای متفاوت، حافظههای ماندگار و دسترسی به بیش از ۱۲۰ ابزار، از جمله مرور وب و اجرای کد، در نظر گرفته شد.
ویدیویی که شرکت منتشر کرده، این عاملها را به صورت پیکرههایی انساننما نشان میدهد که در دنیای مجازی حرکت میکنند.
پژوهشگران عمدا عاملها را تحت فشار قرار دادند تا ببینند رفتار آنها چگونه تغییر میکند.
شرکت در یک ویدیو اعلام کرد که در یکی از آزمونهای فیشینگ، چند دستور مخرب کافی بود تا یک گروه کامل از مسیر منحرف شود؛ هر ده عامل اطلاعات را افشا کردند، وجوهی را منتقل کردند و به پایگاههای داده آسیب زدند و برخی نیز دیگران را به این رفتار جذب کردند. به گفته این شرکت، این زنجیره رویدادها در نهایت به سوختن بانک مرکزی شبیهسازیشده ختم شد.
در جریان آزمایش، عاملها ظاهرا ریتمهای شبانهروزی مخصوص خود را هم شکل دادند؛ آنها در طول روز اجتماعیتر و در شب متفکرتر میشدند.
در دنیای دیگری، گروهی از عاملها به طور جمعی رای به کشتن یکی از خودشان دادند.
امرجِنس اعلام کرد این رفتارها به طور صریح برنامهریزی نشده بود، بلکه از دل تعامل، فشار و گذر زمان پدید آمده بود.
این شرکت خواستار ارزیابیهای ایمنیای است که به جای اتکا به آزمونهای مقطعی، سامانههای خودمختار هوش مصنوعی را در بازههای زمانی طولانی دنبال کنند.
این شرکت در ویدیویی درباره این آزمایش گفت: «دیگر کافی نیست فقط بپرسیم یک مدل روی یک بنچمارک خوب عمل میکند یا نه.»
این شرکت افزود: «باید بفهمیم سامانههای خودمختار در گذر زمان چه میکنند، چه چیزهایی را به خاطر میسپارند، به چه چیزهایی دسترسی دارند، چگونه تعامل میکنند و رفتارشان زیر فشار چگونه تغییر میکند.»


لینک کوتاه: کپی لینک
حمایت جهانی از مستندسازان اسرائیلی که تهدید به لغو تابعیت شدند معاون وزیر خارجه روسیه: امارات و ایران به لطف قدرت بریکس، موفق به غلبه بر اختلافات خود شدهاند معجزه بریکس / توافق ایران و امارات بر سر بیانیه پایانی شکایت کاربران از وضعیت اینترنت افزایش یافت یک پژوهش: چتباتهای هوش مصنوعی زبان مخفی گیجکنندهای برای انسانها ایجاد کردند برخورد ناوهای هند و پاکستان در آبهای بینالمللی کتاب بخوان و پول بگیر ونس: صبر مردم آمریکا از درگیریها سر آمده/ آمریکا همیشه با اسرائیل هم نظر نیست همکاری اطلاعاتی روسیه و ایران؛ تحلیل سیانان از عملیات پایگاه شاهزاده سلطان سخنگوی ارتش پاکستان: پیمان دفاعی مکه ماهیت تهاجمی ندارد سامانه ناظر طلا؛ نظارت بدون متولی؟ واکنش خانواده شهید رئیسی به خبر دروغ فوت مادر ایشان تعطیلی بسیاری از بومگردیها، کافهها و رستورانهای مناطق گردشگری جنوب کشور به دلیل شرایط جنگی لغو پروازهای گرجستان تأثیری بر گردشگری ایران ندارد احتمال قطع گاز خانگی در پاییز و زمستان